Manutenção da Base de Conhecimento via API
Manutenção da Base de Conhecimento via API
A autenticação e os métodos de invocação são consistentes com a API de Serviço da aplicação. A diferença é que um único token da API da base de conhecimento pode operar em todas as bases de conhecimento.
Vantagens de Usar a API da Base de Conhecimento:
- Sincronize seu sistema de dados com as bases de conhecimento do Paragraph para criar fluxos de trabalho poderosos.
- Forneça listas de bases de conhecimento, documentos e consultas de detalhes para facilitar a construção da sua própria página de gerenciamento de dados.
- Suporte upload e atualização de documentos em texto simples ou arquivo, além de adição e modificação em massa ao nível de segmento para simplificar o processo de sincronização.
- Reduza o tempo gasto em processamento e sincronização manual de documentos, aumentando a visibilidade sobre o software e serviços do Paragraph.
Como Usar
Navegue até a página da base de conhecimento e você poderá alternar para a página API ACCESS a partir da navegação à esquerda. Nesta página, você pode visualizar a documentação da API do dataset fornecida pelo Paragraph e gerenciar as credenciais para acessar a API do dataset em API Keys.
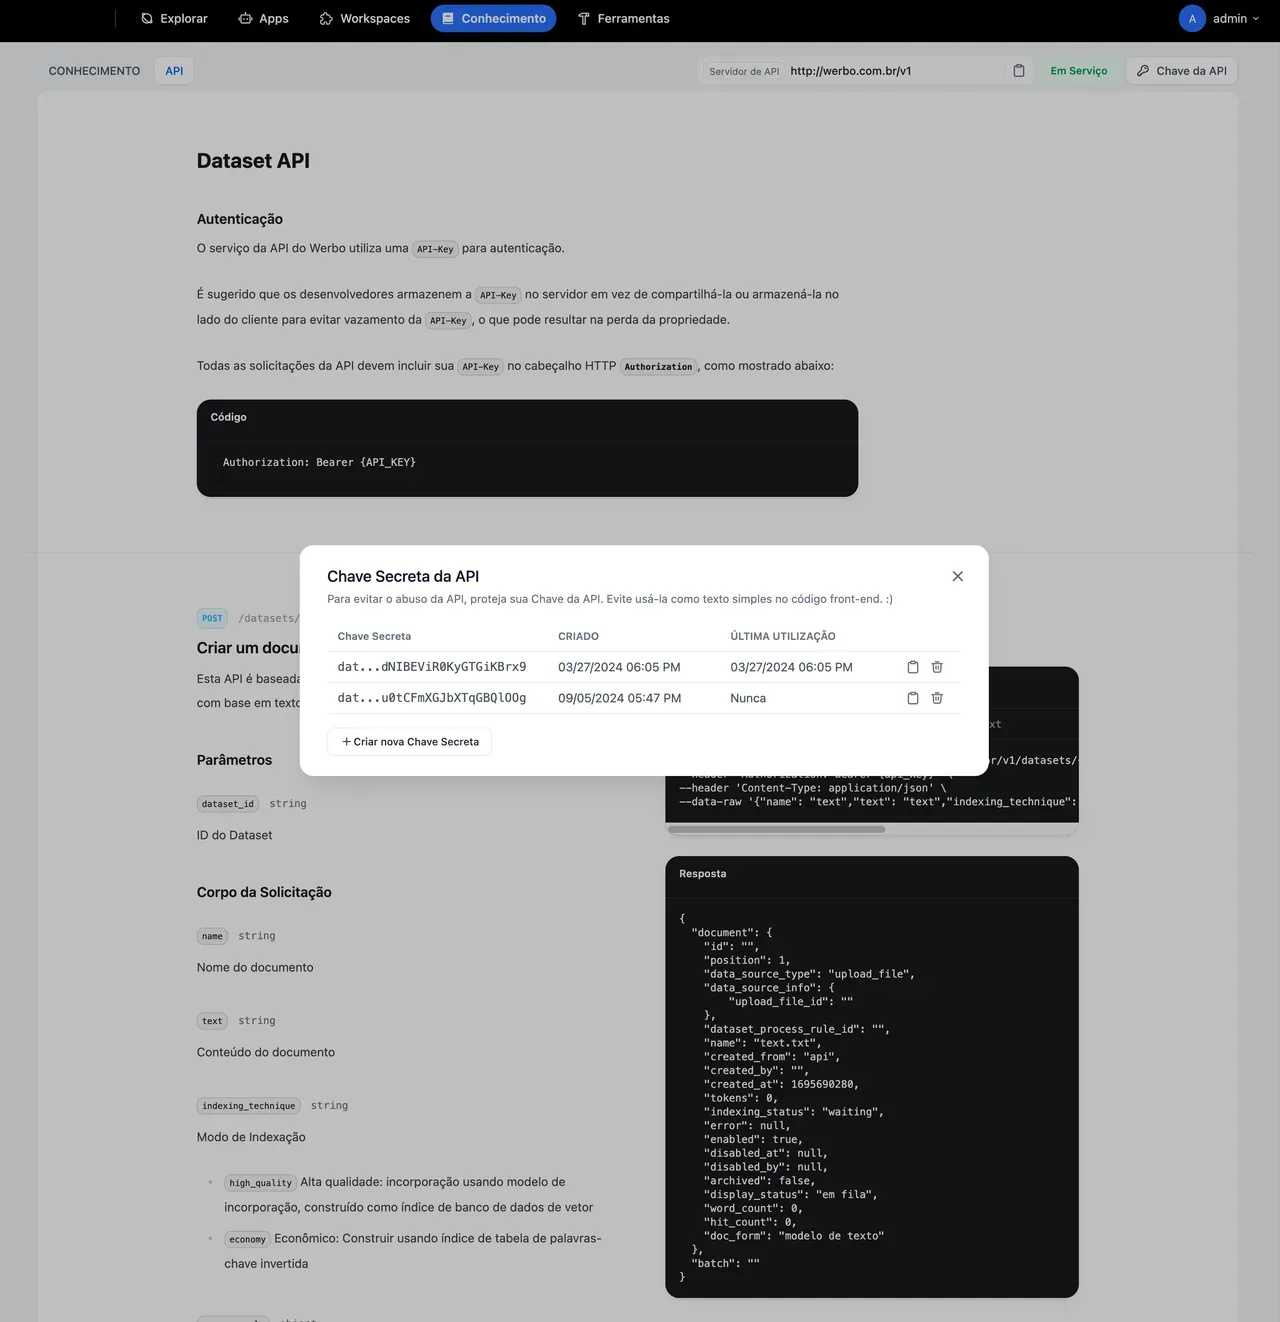
Exemplos de Chamadas da API:
Criar um Dataset Vazio Somente usado para criar um dataset vazio.
curl --location --request POST 'https://api.paragraph.ai/v1/datasets' \
--header 'Authorization: Bearer {api_key}' \
--header 'Content-Type: application/json' \
--data-raw '{"name": "name"}'
Lista de Datasets
curl --location --request GET 'https://api.paragraph.ai/v1/datasets?page=1&limit=20' \
--header 'Authorization: Bearer {api_key}'
Criar Documento por Texto
curl --location --request POST 'https://api.paragraph.ai/v1/datasets/<uuid:dataset_id>/document/create_by_text' \
--header 'Authorization: Bearer {api_key}' \
--header 'Content-Type: application/json' \
--data-raw '{
    "name": "paragraph",
    "text": "paragraph means Do it for you...",
    "indexing_technique": "high_quality",
    "process_rule": {
        "rules": {
                "pre_processing_rules": [{
                        "id": "remove_extra_spaces",
                        "enabled": true
                }, {
                        "id": "remove_urls_emails",
                        "enabled": true
                }],
                "segmentation": {
                        "separator": "###",
                        "max_tokens": 500
                }
        },
        "mode": "custom"
    }
}'
Criar Documento por Arquivo
curl --location POST 'https://api.paragraph.ai/v1/datasets/{dataset_id}/document/create_by_file' \
--header 'Authorization: Bearer {api_key}' \
--form 'data="{
	"name": "paragraph",
	"indexing_technique": "high_quality",
	"process_rule": {
		"rules": {
			"pre_processing_rules": [{
				"id": "remove_extra_spaces",
				"enabled": true
			}, {
				"id": "remove_urls_emails",
				"enabled": true
			}],
			"segmentation": {
				"separator": "###",
				"max_tokens": 500
			}
		},
		"mode": "custom"
	}
    }";
    type=text/plain' \
--form 'file=@"/path/to/file"'
Obter Status de Indexação de Documento (Progresso)
curl --location --request GET 'https://api.paragraph.ai/v1/datasets/{dataset_id}/documents/{batch}/indexing-status' \
--header 'Authorization: Bearer {api_key}'
Excluir Documento
curl --location --request DELETE 'https://api.paragraph.ai/v1/datasets/{dataset_id}/documents/{document_id}' \
--header 'Authorization: Bearer {api_key}'
Lista de Documentos do Dataset
curl --location --request GET 'https://api.paragraph.ai/v1/datasets/{dataset_id}/documents' \
--header 'Authorization: Bearer {api_key}'
Adicionar Segmentos
curl --location 'https://api.paragraph.ai/v1/datasets/{dataset_id}/documents/{document_id}/segments' \
--header 'Authorization: Bearer {api_key}' \
--header 'Content-Type: application/json' \
--data '{"segments": [{"content": "1","answer": "1","keywords": ["a"]}]}'
Excluir Segmento de Documento
curl --location --request DELETE 'https://api.paragraph.ai/v1/datasets/{dataset_id}/segments/{segment_id}' \
--header 'Authorization: Bearer {api_key}' \
--header 'Content-Type: application/json'
Mensagens de Erro Comuns:
- document_indexing: Falha na indexação do documento.
- provider_not_initialize: Modelo de embedding não configurado.
- not_found: Documento não encontrado.
- dataset_name_duplicate: Nome do dataset duplicado.
- provider_quota_exceeded: Limite de uso do modelo excedido.
- dataset_not_initialized: Dataset não inicializado.
- unsupported_file_type: Tipo de arquivo não suportado.
- too_many_files: Muitos arquivos, atualmente apenas upload de arquivo único é suportado.
- file_too_large: Arquivo muito grande, suporta arquivos abaixo de 15MB.