Integrar Modelos Locais Implantados pelo Xinference
O Xorbits inference é uma biblioteca poderosa e versátil, projetada para atender modelos de linguagem, reconhecimento de fala e multimodais, podendo até ser usada em laptops. Ela suporta vários modelos compatíveis com GGML, como chatglm, baichuan, whisper, vicuna, orca, etc. O Paragraph suporta a conexão com as capacidades de inferência de grandes modelos de linguagem e de embedding implantados localmente pelo Xinference.
Implantando o Xinference
Note que geralmente não é necessário encontrar manualmente o endereço IP do contêiner Docker para acessar o serviço, pois o Docker oferece um recurso de mapeamento de portas. Isso permite que você mapeie as portas do contêiner para as portas da máquina local, permitindo o acesso via seu endereço local. Por exemplo, se você usou o parâmetro -p 80:80 ao executar o contêiner, você pode acessar o serviço dentro do contêiner visitando http://localhost:80 ou http://127.0.0.1:80.
Se você realmente precisar usar diretamente o endereço IP do contêiner, os passos acima irão ajudá-lo a obter essa informação.
Iniciando o Xinference
Existem duas maneiras de implantar o Xinference, nomeadamente implantação local e implantação distribuída. Aqui, tomaremos a implantação local como exemplo.
- Primeiro, instale o Xinference via PyPI:
$ pip install "xinference[all]"- Inicie o Xinference localmente:
$ xinference-local
2023-08-20 19:21:05,265 xinference   10148 INFO     Xinference iniciado com sucesso. Endpoint: http://127.0.0.1:9997
2023-08-20 19:21:05,266 xinference.core.supervisor 10148 INFO     Worker 127.0.0.1:37822 foi adicionado com sucesso
2023-08-20 19:21:05,267 xinference.deploy.worker 10148 INFO     Worker do Xinference iniciado com sucesso.
O Xinference iniciará um worker localmente por padrão, com o endpoint: http://127.0.0.1:9997, e a porta padrão é 9997. Por padrão, o acesso é limitado apenas à máquina local, mas pode ser configurado com -H 0.0.0.0 para permitir o acesso de qualquer cliente não local. Para modificar o host ou a porta, você pode consultar as informações de ajuda do Xinference: xinference-local --help.
Se você usar o método de implantação do Docker do Paragraph, precisa prestar atenção à configuração de rede para garantir que o contêiner do Paragraph possa acessar o endpoint do Xinference. O contêiner do Paragraph não pode acessar o localhost internamente, e você precisará usar o endereço IP do host.
- Criar e implantar o modelo
Visite http://127.0.0.1:9997, selecione o modelo e a especificação que você precisa implantar, conforme mostrado abaixo:
Como diferentes modelos têm diferentes compatibilidades em diferentes plataformas de hardware, consulte os modelos integrados do Xinference para garantir que o modelo criado suporte a plataforma de hardware atual.
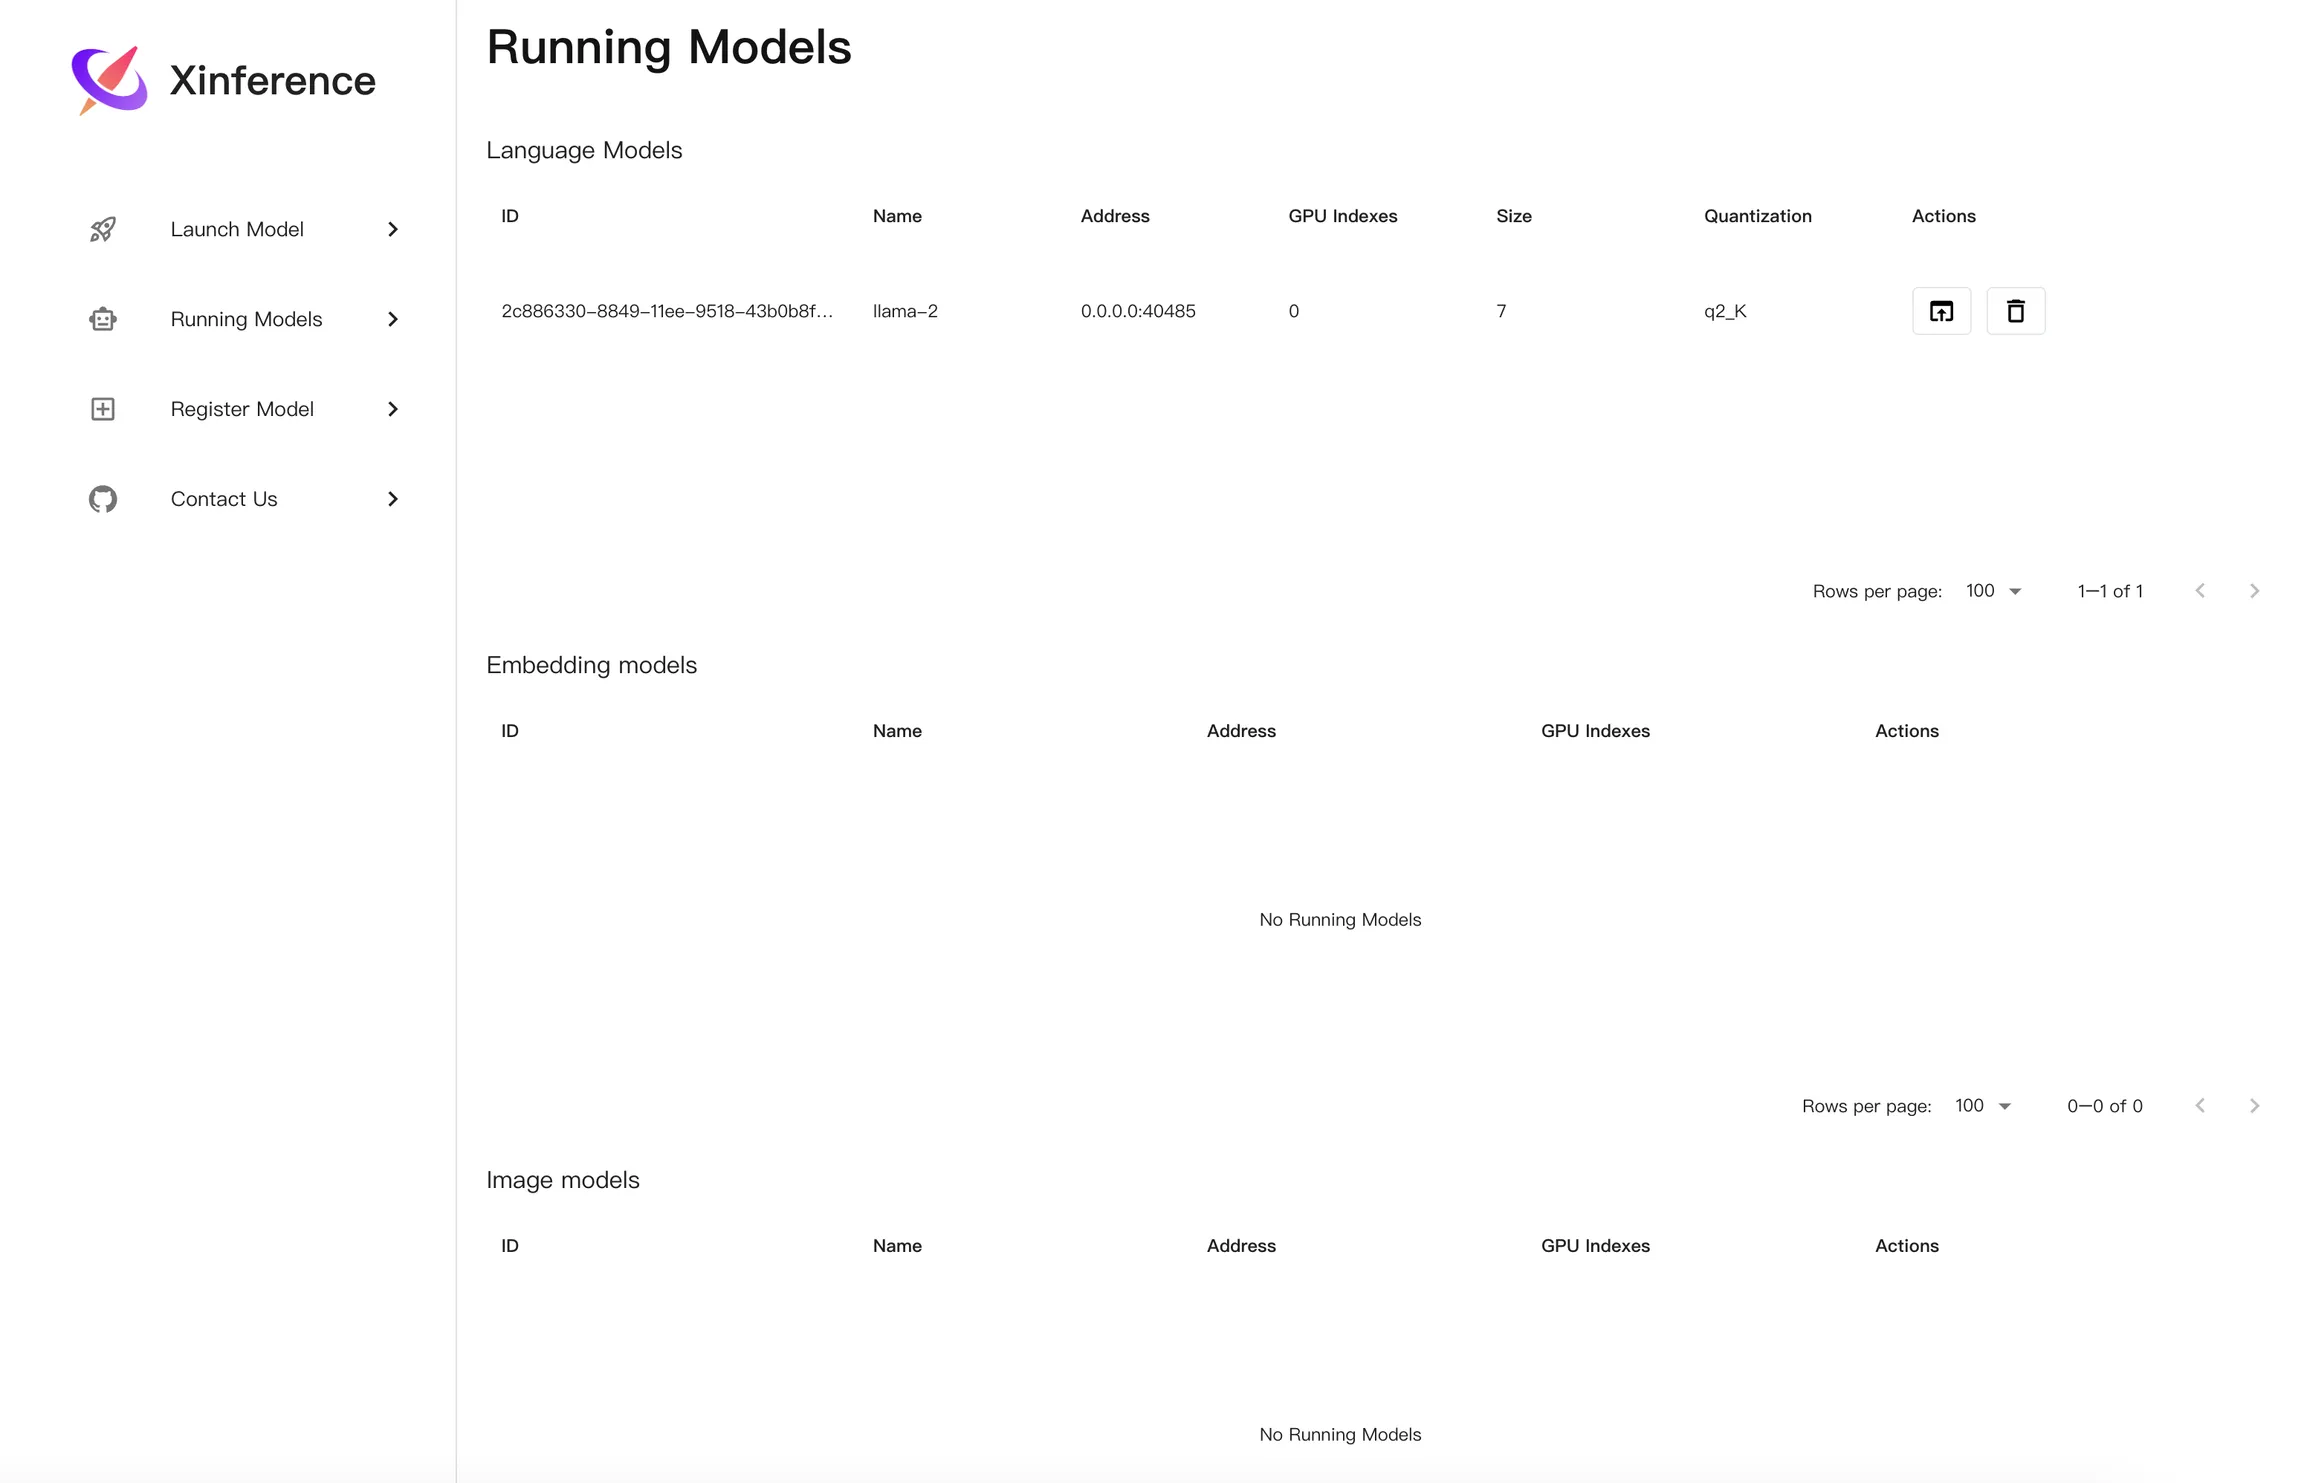
- Obter o UID do modelo
Copie o ID do modelo na página de Modelos em Execução, como: 2c886330-8849-11ee-9518-43b0b8f40bea.
- Depois que o modelo for implantado, conecte o modelo implantado no Paragraph.
Em Configurações > Provedores de Modelos > Xinference, insira:
- Nome do modelo: vicuna-v1.3
- URL do servidor: http://<IP_da_Máquina>:9997 (Substitua pelo endereço IP da sua máquina)
- UID do modelo: 2c886330-8849-11ee-9518-43b0b8f40bea
Clique em "Salvar" para usar o modelo no aplicativo Paragraph.
O Paragraph também suporta o uso de modelos integrados do Xinference como modelos de Embedding, basta selecionar o tipo Embeddings na caixa de configuração.
Para mais informações sobre o Xinference, consulte: Xorbits Inference.