Integrar Modelos Locais Implantados pelo Ollama
O Ollama é um cliente de framework de inferência local que permite a implantação com um clique de LLMs, como Llama 2, Mistral, Llava, entre outros. O Paragraph suporta a integração das capacidades de LLM e Text Embedding de grandes modelos de linguagem implantados com o Ollama.
Integração Rápida
Baixar e Iniciar o Ollama
- Baixar Ollama
Visite https://ollama.ai/download para baixar o cliente Ollama para o seu sistema.
- Execute o Ollama e converse com o Llava
ollama run llavaApós o lançamento bem-sucedido, o Ollama inicia um serviço de API na porta local 11434, que pode ser acessado em http://localhost:11434.
Para outros modelos, visite Ollama Models para mais detalhes.
- Integrar Ollama no Paragraph
Em Configurações > Provedores de Modelos > Ollama, preencha:
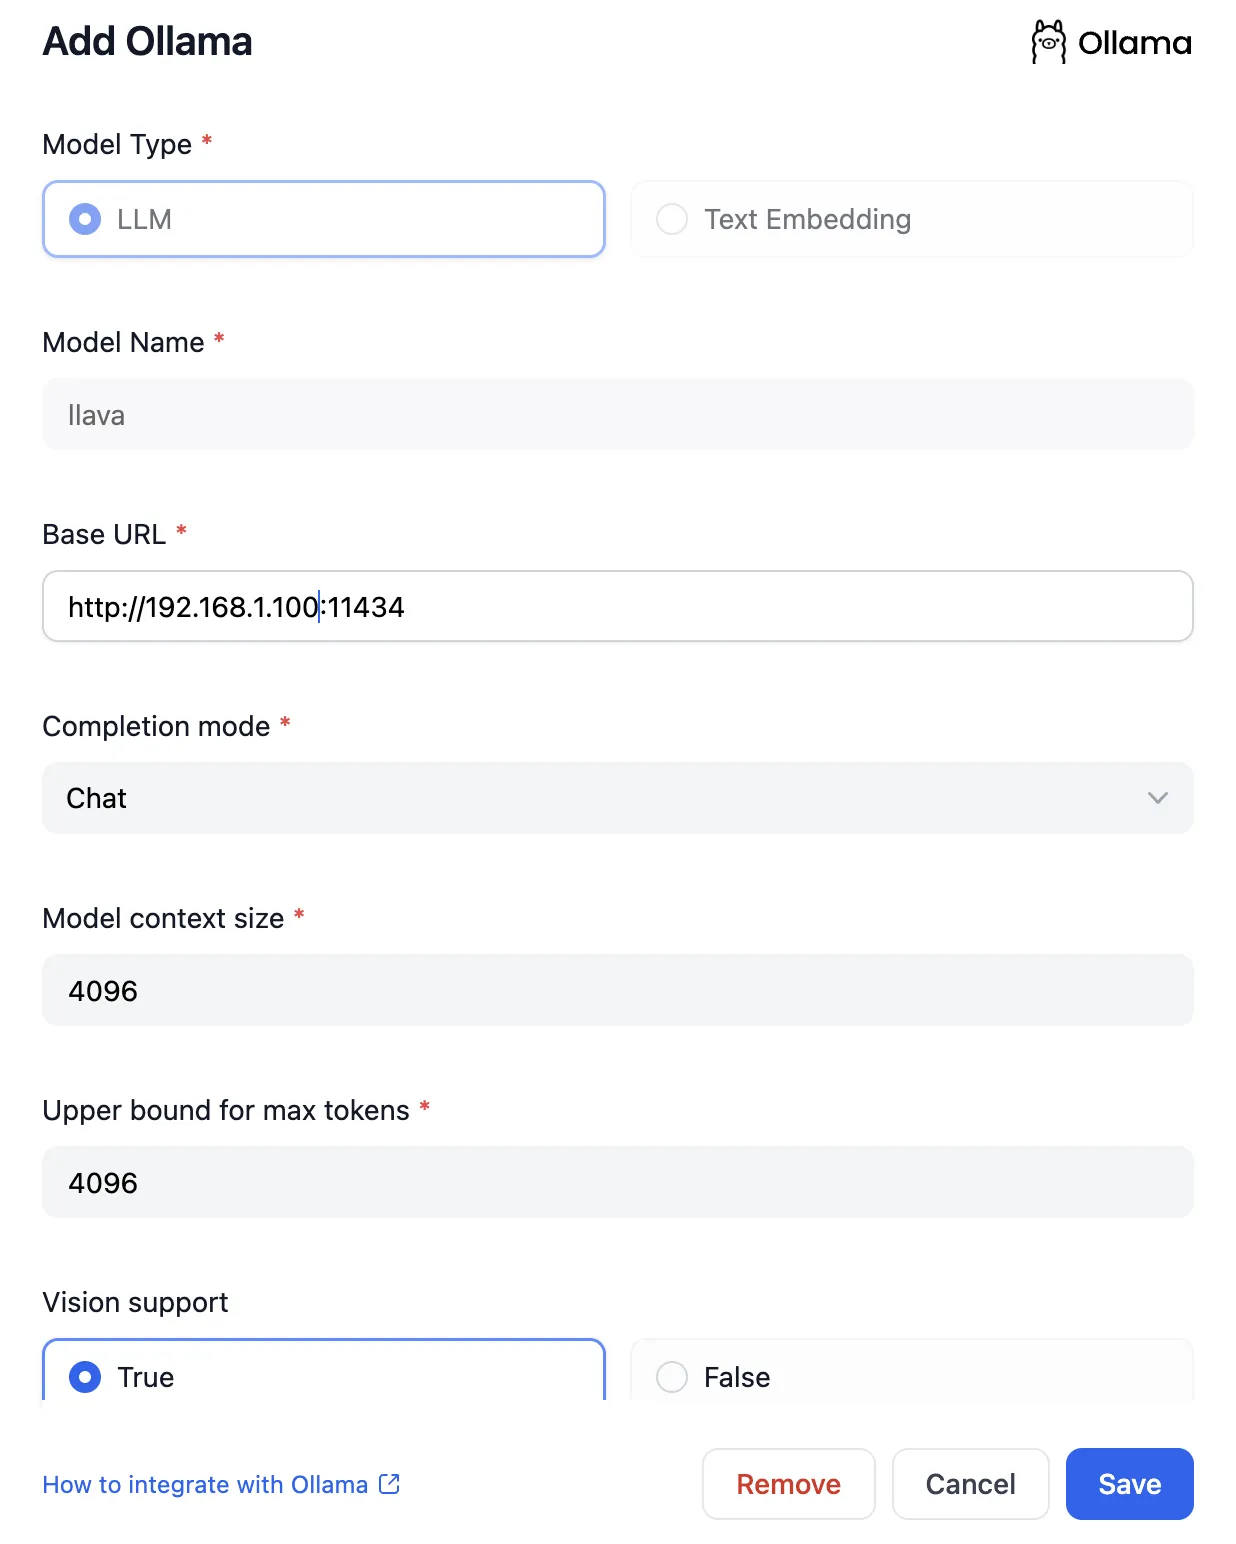
- Nome do Modelo: llava
- URL Base: http://<seu-domínio-endpoint-do-ollama>:11434
- Tipo de Modelo: Chat
- Comprimento do Contexto do Modelo: 4096O comprimento máximo de contexto do modelo. Se não tiver certeza, use o valor padrão de 4096.
- Limite Máximo de Tokens: 4096O número máximo de tokens retornados pelo modelo. Se não houver requisitos específicos para o modelo, isso pode ser consistente com o comprimento do contexto do modelo.
- Suporte para Visão: SimMarque esta opção se o modelo suportar compreensão de imagens (multimodal), como o llava.
Clique em "Salvar" para usar o modelo no aplicativo após verificar que não há erros.
O método de integração para modelos de Embeddings é semelhante ao de LLM, basta alterar o tipo de modelo para Text Embedding.
Usar Modelos Ollama
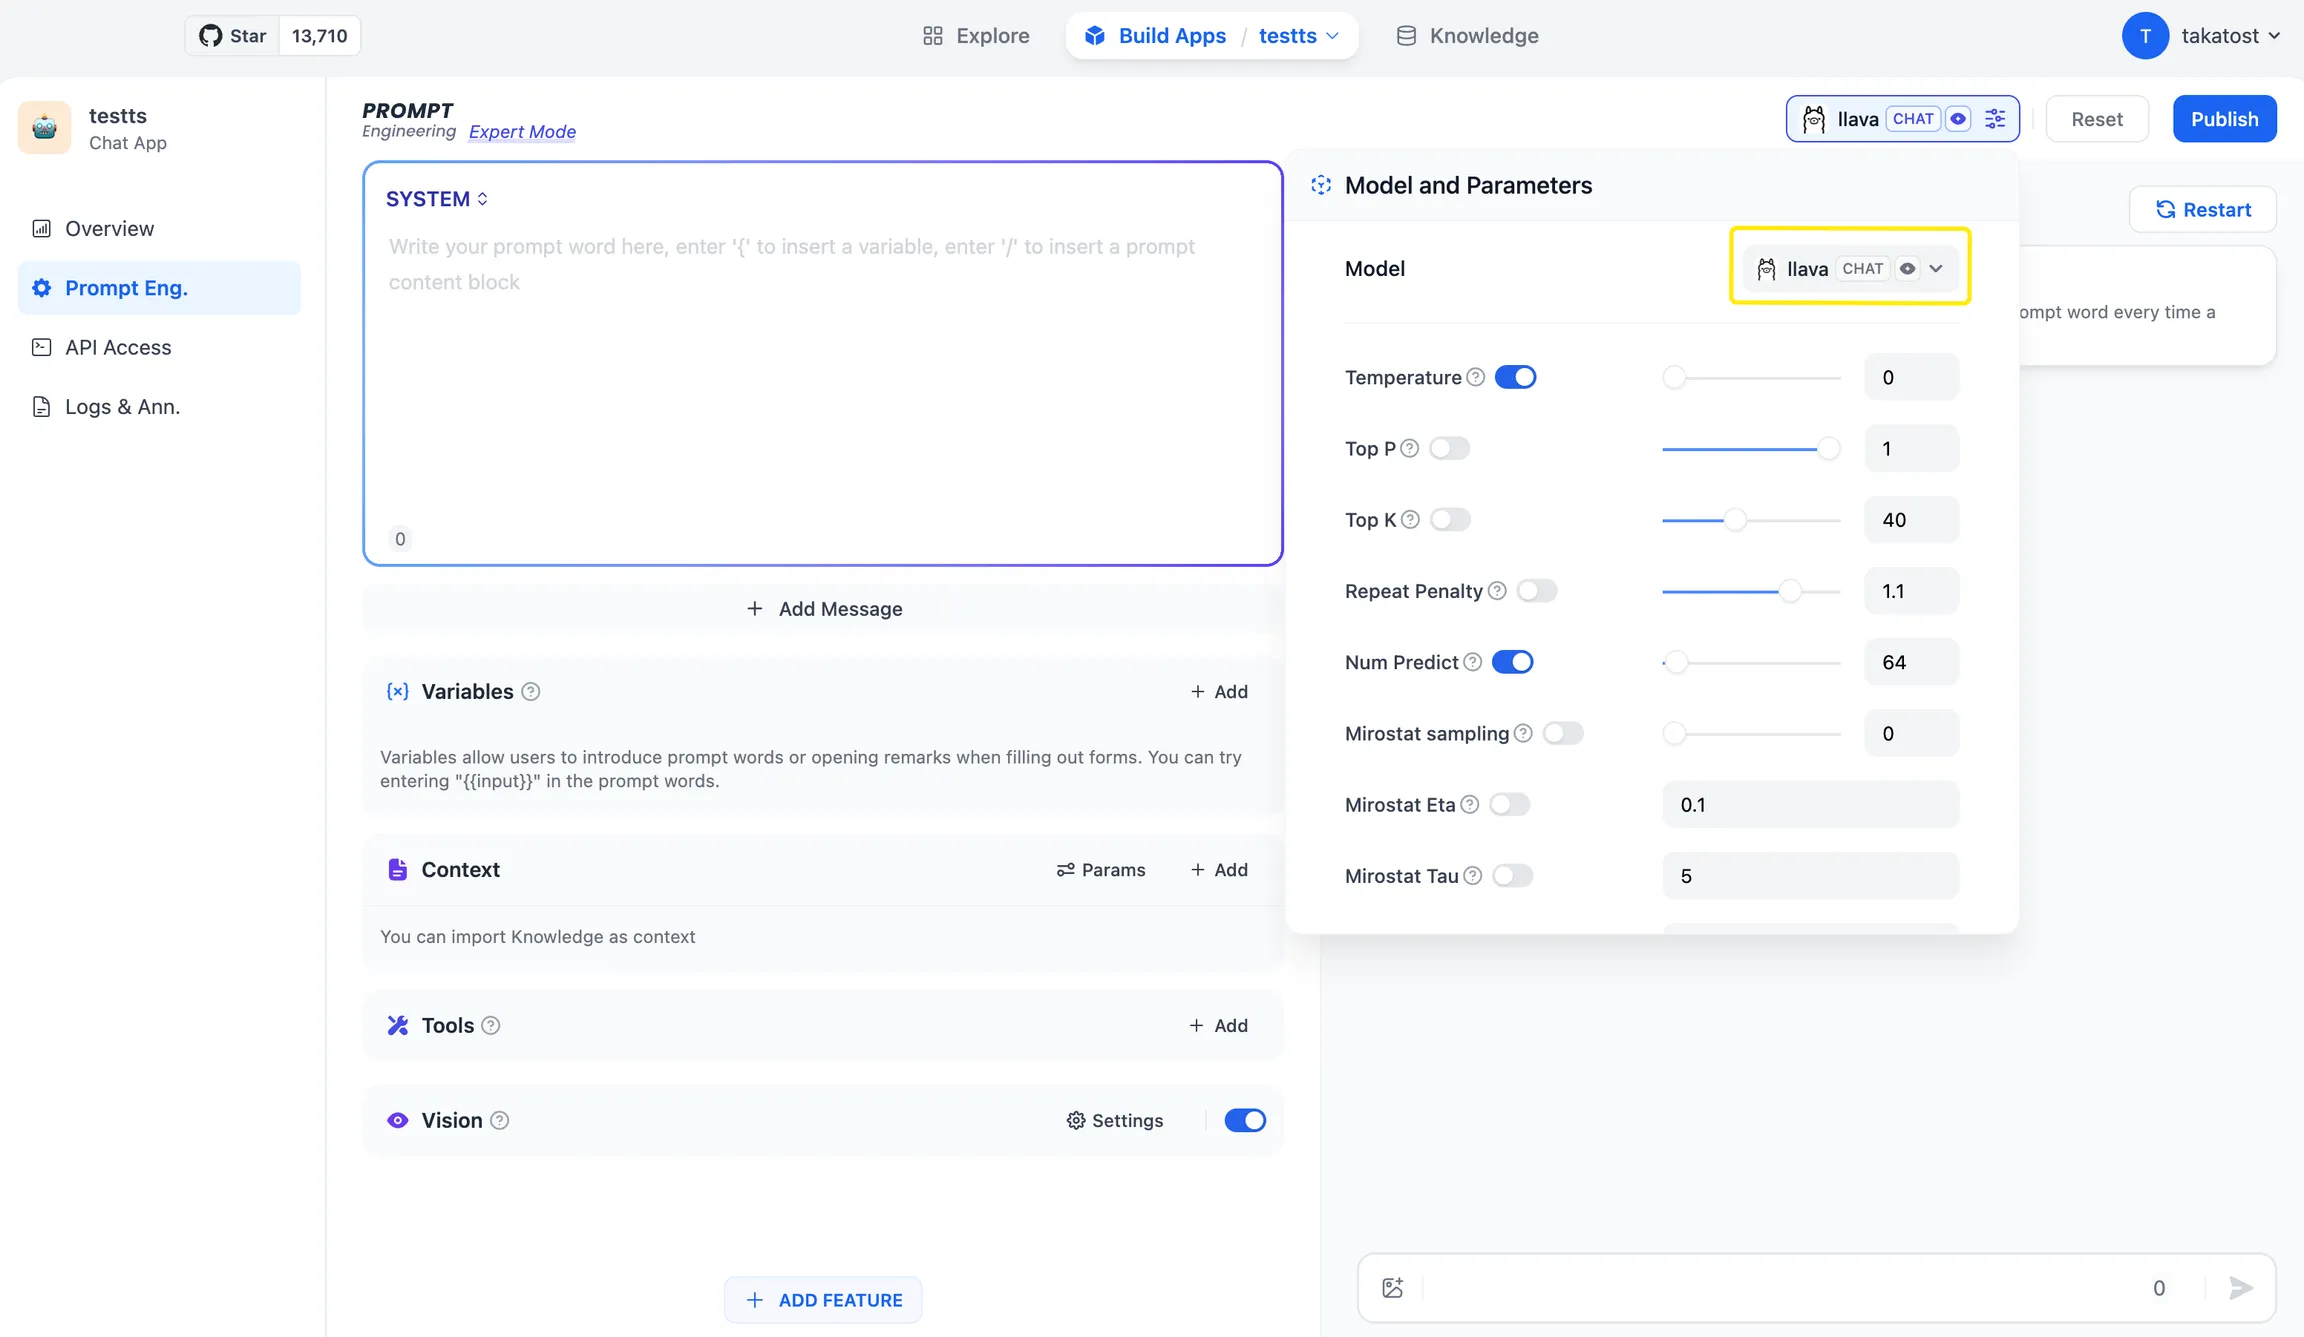
Acesse a página de Prompt Eng. do aplicativo que precisa ser configurado, selecione o modelo llava sob o provedor Ollama e use-o após configurar os parâmetros do modelo.
FAQ
⚠️ Se você estiver usando Docker para implantar o Paragraph e o Ollama, pode encontrar o seguinte erro:
httpconnectionpool(host=127.0.0.1, port=11434): max retries exceeded with url:/cpi/chat (Caused by NewConnectionError('<urllib3.connection.HTTPConnection object at 0x7f8562812c20>: fail to establish a new connection:[Errno 111] Connection refused'))Esse erro ocorre porque o serviço Ollama não está acessível a partir do contêiner Docker. O localhost geralmente se refere ao próprio contêiner, não à máquina host ou a outros contêineres. Para resolver esse problema, você precisa expor o serviço Ollama para a rede.
Configurando variáveis de ambiente no Mac
Se o Ollama for executado como um aplicativo macOS, as variáveis de ambiente devem ser configuradas usando launchctl:
Para cada variável de ambiente, chame launchctl setenv.
launchctl setenv OLLAMA_HOST "0.0.0.0"Reinicie o aplicativo Ollama.
Se os passos acima não forem eficazes, você pode usar o seguinte método:
O problema está no próprio Docker, e para acessar o host do Docker, você deve conectar-se ao host.docker.internal. Portanto, substituir localhost por host.docker.internal no serviço fará com que funcione corretamente.
http://host.docker.internal:11434Configurando variáveis de ambiente no Linux
Se o Ollama for executado como um serviço systemd, as variáveis de ambiente devem ser configuradas usando systemctl:
Edite o serviço systemd chamando systemctl edit ollama.service. Isso abrirá um editor.
Para cada variável de ambiente, adicione uma linha Environment na seção [Service]:
[Service]
Environment="OLLAMA_HOST=0.0.0.0"
Salve e saia.
Recarregue o systemd e reinicie o Ollama:
systemctl daemon-reload
systemctl restart ollama
Configurando variáveis de ambiente no Windows
No Windows, o Ollama herda suas variáveis de ambiente de usuário e sistema.
Primeiro, saia do Ollama clicando nele na barra de tarefas.
Edite as variáveis de ambiente do sistema no painel de controle.
Edite ou crie novas variáveis para sua conta de usuário para OLLAMA_HOST, OLLAMA_MODELS, etc.
Clique em OK/Aplicar para salvar.
Execute o Ollama em uma nova janela de terminal.
Como posso expor o Ollama na minha rede?
O Ollama vincula o 127.0.0.1 à porta 11434 por padrão. Altere o endereço de vinculação com a variável de ambiente OLLAMA_HOST.