Integração de Modelos Customizados
Introdução
Após concluir a integração do fornecedor, o próximo passo é integrar os modelos sob o fornecedor. Para ajudar a entender todo o processo de integração, usaremos o Xinference como exemplo para completar gradualmente uma integração completa de fornecedor.
É importante notar que, para modelos customizados, cada integração de modelo requer uma credencial completa do fornecedor.
Diferente dos modelos predefinidos, a integração de fornecedores customizados sempre terá os seguintes dois parâmetros, que não precisam ser definidos no arquivo YAML do fornecedor.
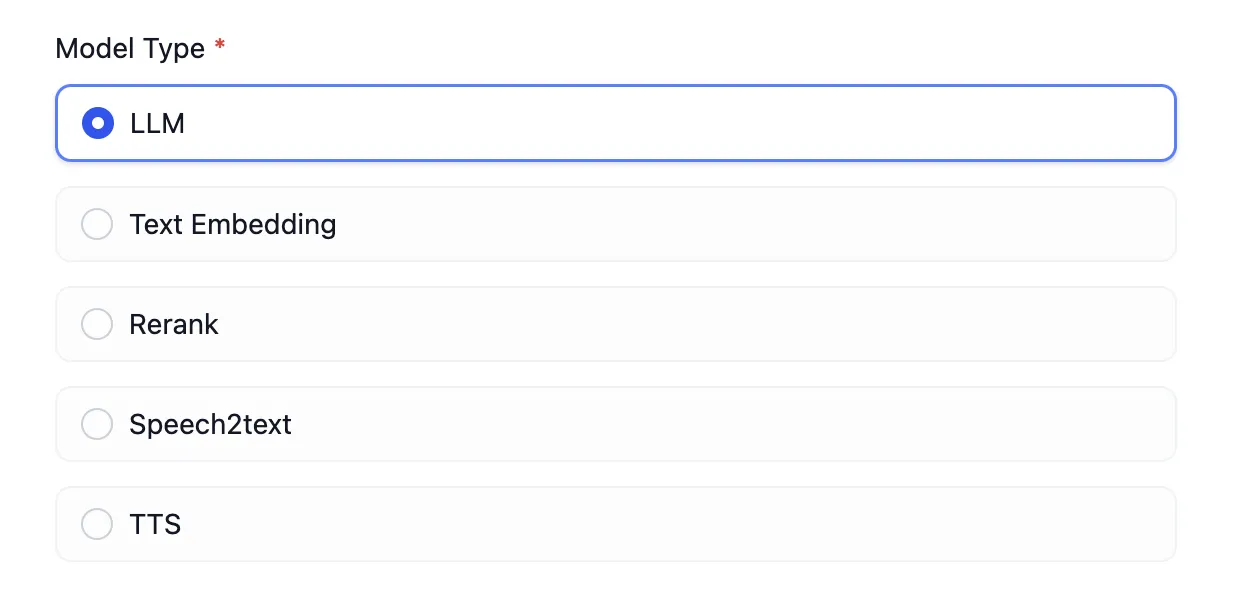
Na seção anterior, aprendemos que os fornecedores não precisam implementar validate_provider_credential. O Runtime chamará automaticamente a validate_credentials da camada do modelo correspondente, com base no tipo e nome do modelo selecionado pelo usuário para validação.
Escrevendo o YAML do Fornecedor
Primeiro, precisamos determinar quais tipos de modelos o fornecedor suporta.
Atualmente, os tipos de modelos suportados são os seguintes:
- llm: Modelo de Geração de Texto
- text_embedding: Modelo de Embedding de Texto
- rerank: Modelo de Reclassificação
- speech2text: Fala para Texto
- tts: Texto para Fala
- moderation: Moderação
O Xinference suporta LLM, Text Embedding e Rerank, então começaremos a escrever o xinference.yaml.
provider: xinference # Especifica o identificador do fornecedor
label: # Nome de exibição do fornecedor, pode ser definido em en_US (Inglês).
  en_US: Xorbits Inference
icon_small: # Ícone pequeno, referencie os ícones de outros fornecedores, armazenados no diretório _assets sob o diretório de implementação correspondente ao fornecedor. A estratégia de idioma é a mesma do label.
  en_US: icon_s_en.svg
icon_large: # Ícone grande
  en_US: icon_l_en.svg
help: # Ajuda
  title:
    en_US: How to deploy Xinference
  url:
    en_US: https://github.com/xorbitsai/inference
supported_model_types: # Tipos de modelos suportados. Xinference suporta LLM/Text Embedding/Rerank
- llm
- text-embedding
- rerank
configurate_methods: # Como o Xinference é um fornecedor implementado localmente e não possui modelos predefinidos, você precisa implantar os modelos necessários de acordo com a documentação do Xinference. Portanto, apenas modelos customizados são suportados aqui.
- customizable-model
provider_credential_schema:
  credential_form_schemas:
Em seguida, precisamos considerar quais credenciais são necessárias para definir um modelo no Xinference.
Ele suporta três tipos diferentes de modelos, então precisamos de model_type para especificar o tipo do modelo. São três tipos, então escreveremos da seguinte forma:
provider_credential_schema:
  credential_form_schemas:
  - variable: model_type
    type: select
    label:
      en_US: Model type
    required: true
    options:
    - value: text-generation
      label:
        en_US: Language Model
    - value: embeddings
      label:
        en_US: Text Embedding
    - value: reranking
      label:
        en_US: Rerank
Cada modelo tem seu próprio nome model_name, então precisamos defini-lo aqui.
  - variable: model_name
    type: text-input
    label:
      en_US: Model name
    required: true
    placeholder:
      en_US: Input model name
Forneça o endereço para a implantação local do Xinference.
  - variable: server_url
    label:
      en_US: Server url
    type: text-input
    required: true
    placeholder:
      en_US: Enter the url of your Xinference, for example https://example.com/xxx
Cada modelo tem um model_uid único, então precisamos defini-lo aqui.
  - variable: model_uid
    label:
      en_US: Model uid
    type: text-input
    required: true
    placeholder:
      en_US: Enter the model uid
Agora, completamos a definição básica do fornecedor.
Escrevendo o Código do Modelo
Em seguida, tomaremos o tipo llm como exemplo e escreveremos xinference.llm.llm.py.
No llm.py, crie uma classe XinferenceLLM, que chamaremos de XinferenceAILargeLanguageModel (nome arbitrário), herdando da classe base __base.large_language_model.LargeLanguageModel. Implemente os seguintes métodos:
Invocação do LLM
Implemente o método principal para invocação do LLM, que pode suportar retornos em streaming e síncronos.
def _invoke(self, model: str, credentials: dict,
            prompt_messages: list[PromptMessage], model_parameters: dict,
            tools: Optional[list[PromptMessageTool]] = None, stop: Optional[List[str]] = None,
            stream: bool = True, user: Optional[str] = None) \
        -> Union[LLMResult, Generator]:
    """
    Invocar o modelo de linguagem grande

    :param model: nome do modelo
    :param credentials: credenciais do modelo
    :param prompt_messages: mensagens de prompt
    :param model_parameters: parâmetros do modelo
    :param tools: ferramentas para chamada de ferramentas
    :param stop: palavras de parada
    :param stream: resposta em streaming
    :param user: ID único do usuário
    :return: resposta completa ou gerador de resposta em streaming
    """
Ao implementar, observe que você precisa usar duas funções para retornar dados, uma para lidar com retornos síncronos e outra para retornos em streaming. Isso ocorre porque o Python identifica funções que contêm a palavra-chave yield como funções geradoras, e o tipo de dado retornado é fixado como Generator. Portanto, os retornos síncronos e em streaming precisam ser implementados separadamente, conforme mostrado abaixo (observe que o exemplo usa parâmetros simplificados; a implementação real deve seguir a lista de parâmetros acima):
def _invoke(self, stream: bool, **kwargs) \
        -> Union[LLMResult, Generator]:
    if stream:
          return self._handle_stream_response(**kwargs)
    return self._handle_sync_response(**kwargs)

def _handle_stream_response(self, **kwargs) -> Generator:
    for chunk in response:
          yield chunk
def _handle_sync_response(self, **kwargs) -> LLMResult:
    return LLMResult(**response)
Pré-cálculo de Tokens de Entrada
Se o modelo não fornecer uma interface de pré-cálculo de tokens, pode retornar diretamente 0.
def get_num_tokens(self, model: str, credentials: dict, prompt_messages: list[PromptMessage],
                 tools: Optional[list[PromptMessageTool]] = None) -> int:
  """
  Obter o número de tokens para as mensagens de prompt fornecidas

  :param model: nome do modelo
  :param credentials: credenciais do modelo
  :param prompt_messages: mensagens de prompt
  :param tools: ferramentas para chamada de ferramentas
  :return:
  """
Às vezes, você pode não querer retornar diretamente 0, então pode usar self._get_num_tokens_by_gpt2(text: str) para obter tokens pré-calculados. Este método está localizado na classe base AIModel e usa o Tokenizer do GPT2 para cálculo. No entanto, só pode ser usado como um método alternativo e não é completamente preciso.
Validação das Credenciais do Modelo
Semelhante à validação das credenciais do fornecedor, isso é para validar credenciais individuais do modelo.
def validate_credentials(self, model: str, credentials: dict) -> None:
    """
    Validar as credenciais do modelo

    :param model: nome do modelo
    :param credentials: credenciais do modelo
    :return:
    """
Esquema de Parâmetros do Modelo
Diferente dos tipos customizados, como os parâmetros suportados por um modelo não são definidos no arquivo YAML, precisamos gerar dinamicamente o esquema de parâmetros do modelo.
Por exemplo, o Xinference suporta os parâmetros max_tokens, temperature e top_p.
No entanto, alguns fornecedores suportam diferentes parâmetros dependendo do modelo. Por exemplo, o fornecedor OpenLLM suporta top_k, mas nem todos os modelos fornecidos por este fornecedor suportam top_k. Aqui, ilustramos que o Modelo A suporta top_k, enquanto o Modelo B não. Portanto, precisamos gerar dinamicamente o esquema de parâmetros do modelo, conforme mostrado abaixo:
def get_customizable_model_schema(self, model: str, credentials: dict) -> AIModelEntity | None:
    """
        Usado para definir o esquema de modelo customizável


    """
    rules = [
        ParameterRule(
            name='temperature', type=ParameterType.FLOAT,
            use_template='temperature',
            label=I18nObject(
                en_US='Temperature'
            )
        ),
        ParameterRule(
            name='top_p', type=ParameterType.FLOAT,
            use_template='top_p',
            label=I18nObject(
                en_US='Top P'
            )
        ),
        ParameterRule(
            name='max_tokens', type=ParameterType.INT,
            use_template='max_tokens',
            min=1,
            default=512,
            label=I18nObject(
                en_US='Max Tokens'
            )
        )
    ]

    # se o modelo for A, adicione top_k às regras
    if model == 'A':
        rules.append(
            ParameterRule(
                name='top_k', type=ParameterType.INT,
                use_template='top_k',
                min=1,
                default=50,
                label=I18nObject(
                    en_US='Top K'
                )
            )
        )

    """
        algum código NÃO IMPORTANTE aqui
    """

    entity = AIModelEntity(
        model=model,
        label=I18nObject(
            en_US=model
        ),
        fetch_from=FetchFrom.CUSTOMIZABLE_MODEL,
        model_type=model_type,
        model_properties={
            ModelPropertyKey.MODE:  ModelType.LLM,
        },
        parameter_rules=rules
    )

    return entity
Tabela de Mapeamento de Erros de Invocação
Quando ocorre um erro de invocação do modelo, ele precisa ser mapeado para o tipo InvokeError especificado pelo Runtime, para facilitar o processamento subsequente da Paragraph para diferentes erros.
Erros de Runtime:
- InvokeConnectionError: Erro de conexão na invocação
- InvokeServerUnavailableError: Servidor de invocação indisponível
- InvokeRateLimitError: Limite de taxa de invocação atingido
- InvokeAuthorizationError: Falha na autorização da invocação
- InvokeBadRequestError: Erro de parâmetro na invocação
@property
def _invoke_error_mapping(self) -> dict[type[InvokeError], list[type[Exception]]]:
    """
    Mapear erro de invocação do modelo para erro unificado
    A chave é o tipo de erro lançado para o chamador
    O valor é o tipo de erro lançado pelo modelo,
    que precisa ser convertido em um tipo de erro unificado para o chamador.

    :return: Mapeamento de erros de invocação
    """
Para uma explicação dos métodos de interface, consulte: [Interfaces]. Para implementações específicas, consulte: llm.py.